10월 초 일주일 동안 생활 정보형 숏츠를 여러 편 만들었습니다. 대본을 문장 단위로 쪼개 TTS(음성)를 만들고, 문장마다 장면 이미지를 붙이는 방식입니다. Higgsfield 생성 기록을 세어 보니 TTS 클립만 200개가 넘었습니다. 그 과정에서 생긴 규칙을 정리합니다.
일주일 동안 만든 양
| 날짜 | TTS 모델 | TTS 클립 수 | 장면 이미지 |
|---|---|---|---|
| 10월 6일 | Seed Audio / Text to Speech | 96개 / 39개 | — |
| 10월 8일 | Text to Speech | 42개 | 5장 |
| 10월 9일 | Seed Audio | 4개 | — |
| 10월 12일 | Text to Speech | 53개 | 38장 (GPT Image 2, 9:16) |
| 합계 | 234개 |
제작 순서
- 대본을 15~30초 분량으로 쓴다.
- 대본을 한 문장씩 쪼갠다. 문장 하나가 장면 하나가 된다.
- 문장마다 TTS를 만든다. 마음에 안 들면 그 문장만 다시 만든다.
- 문장마다 장면 이미지를 9:16으로 만든다.
- 편집 앱에서 음성 길이에 맞춰 이미지를 배치하고 자막을 올린다.
TTS 규칙 1. 숫자와 영어는 한글로 풀어 쓴다
가장 크게 배운 점입니다. 숫자나 영문 약자를 그대로 넣으면 엉뚱하게 읽는 경우가 있어서, 대본을 아예 읽는 소리대로 한글로 바꿔 넣었습니다.
| 원래 표기 | TTS에 넣은 표기 |
|---|---|
| 10,000원 | 만 원 |
| 80% | 팔십 퍼센트 |
| 170년 | 백칠십 년 |
| 99,000원 | 구만 구천 원 |
| 20분마다 20초, 6m | 이십 분마다, 이십 초 동안, 육 미터 |
TTS 규칙 2. 쉼표로 호흡을 만든다
“그래서 저희는, 목화와 나무 펄프에서 온 소재를 골랐어요.”처럼 쉬어야 할 자리에 쉼표를 넣으면 말하는 속도가 자연스러워졌습니다. 같은 문장을 쉼표 위치만 바꿔 여러 번 만든 것도 이 때문입니다.
TTS 규칙 3. 문장 단위로 만든다
- 한 번에 긴 대본을 넣으면 한 문장만 어색해도 전체를 다시 만들어야 합니다.
- 문장 단위로 만들면 어색한 문장만 다시 생성하면 됩니다.
- 같은 목소리(프리셋)를 끝까지 고정해야 편집했을 때 한 사람이 말하는 것처럼 들립니다.
장면 이미지 규칙
10월 12일에 만든 장면 이미지 38장은 모두 같은 꼬리 문장을 붙였습니다.
..., subject centered in the middle of the frame. No text, no logos, no watermark.| 규칙 | 이유 |
|---|---|
| 9:16 세로 비율 | 숏츠 화면 그대로 쓰기 위해 |
| subject centered | 위아래 자막 자리를 비우고 주제를 가운데 두기 위해 |
| No text, no logos, no watermark | 이미지 속 엉뚱한 글자와 로고 방지 |
| Cinematic photoreal / science documentary look | 정보형 영상에 맞는 다큐멘터리 톤 통일 |
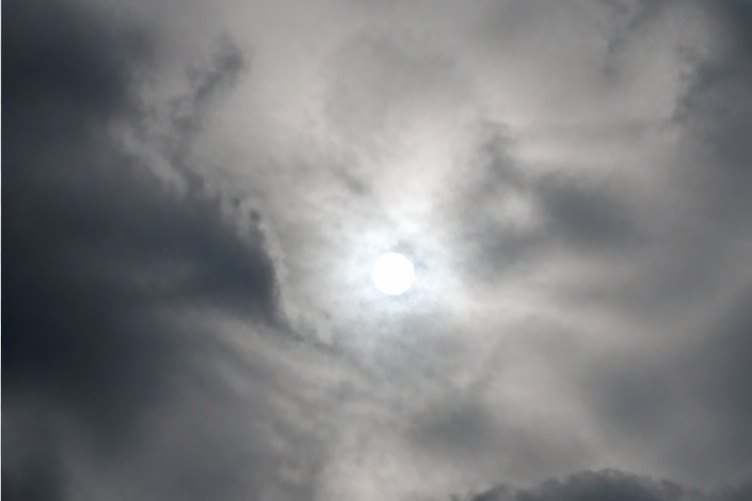
예를 들어 “흐린 날에도 자외선은 내려온다”는 문장에는 아래처럼 구름 사이 해가 비치는 장면을 붙였습니다. 이 글의 대표 이미지가 그 장면입니다.
Cinematic photoreal: thick grey clouds with the sun disc faintly glowing through, dramatic sky, science documentary look, subject centered. No text, no watermark.해보고 알게 된 점
- 정보형 숏츠는 대본이 8할입니다. 문장을 짧게 쪼갤수록 TTS와 이미지 모두 관리가 쉬워집니다.
- 숫자·영어를 한글로 풀어 쓰는 것만으로 다시 만드는 횟수가 크게 줄었습니다.
- 장면 이미지는 꼬리 문장을 고정해 두면 여러 편을 만들어도 톤이 일정합니다.